Pourquoi une IA qui résout des olympiades de maths compte mal sur une simple addition
9.11 plus grand que 9.9 : ce bug bien réel n'a presque rien à voir avec l'intelligence du modèle. La cause se cache dans la tokenisation, avec une preuve chiffrée qui donne le vertige : 99,81 % de précision contre 7,51 % pour le même calcul.
Auteur : Attuoman Prince Josias
Publié le
Un modèle de langage ne voit jamais un nombre comme une quantité : il le découpe en tokens selon la fréquence des caractères, pas selon une logique numérique. 42235630 peut devenir [422, 35, 630].
Preuve chiffrée : sur des additions identiques, la précision de Claude 3.5 Sonnet chute de 99,81 % à 7,51 % quand les chiffres sont remplacés par des symboles arbitraires de même valeur (étude arXiv, 2025).
Des pistes existent (Abacus Embeddings, tokenisation de droite à gauche) mais ne sont pas encore le standard des modèles grand public.
Pour un calcul qui compte vraiment, mieux vaut passer par un outil d'exécution de code plutôt que faire confiance à la mémoire du modèle.
Ce résumé (uniquement ce résumé, pas l'article) est généré par Claude Sonnet 5, relu et validé par Attuoman Prince Josias, auteur de l'article.
Un modèle qui résout des problèmes de niveau olympiade internationale peut, la minute suivante, affirmer que 9.11 est plus grand que 9.9. Ce n'est pas une blague ni un cas isolé : c'est un symptôme documenté, reproductible, et sa cause n'a presque rien à voir avec l'intelligence du modèle. Elle se cache une étape plus tôt, avant même que le calcul ne commence.
Dans cet article :
- Le symptôme : quand 9.11 devient plus grand que 9.9
- La vraie cause : un nombre n'est pas un nombre pour l'IA
- Pourquoi ça empire avec les grands nombres
- Ce que les laboratoires essaient pour corriger le tir
- Ce qu'il faut en retenir
Le symptôme : quand 9.11 devient plus grand que 9.9
Le cas "9.11 contre 9.9" est devenu la démonstration la plus citée d'un problème plus large [1]. Des chercheurs ont formalisé le test : prendre des additions que les modèles réussissent presque parfaitement, puis remplacer chaque chiffre par un symbole arbitraire qui représente exactement la même valeur. Si le modèle "comprenait" vraiment les nombres, le changement de notation ne devrait rien changer. Ce n'est pas ce qu'on observe.
La vraie cause : un nombre n'est pas un nombre pour l'IA
Avant de traiter le moindre mot, un modèle de langage découpe le texte en fragments appelés tokens, via un algorithme nommé BPE. Ce découpage se fait selon la fréquence des séquences de caractères dans les données d'entraînement, pas selon une logique numérique [2]. Un nombre comme 42235630 peut ainsi se retrouver fragmenté en 422, 35, 630 : trois blocs qui ne correspondent à aucune unité, dizaine ou centaine réelle. Changez un seul chiffre, et c'est tout le découpage qui se recompose différemment, sans lien stable avec la valeur du nombre [3].
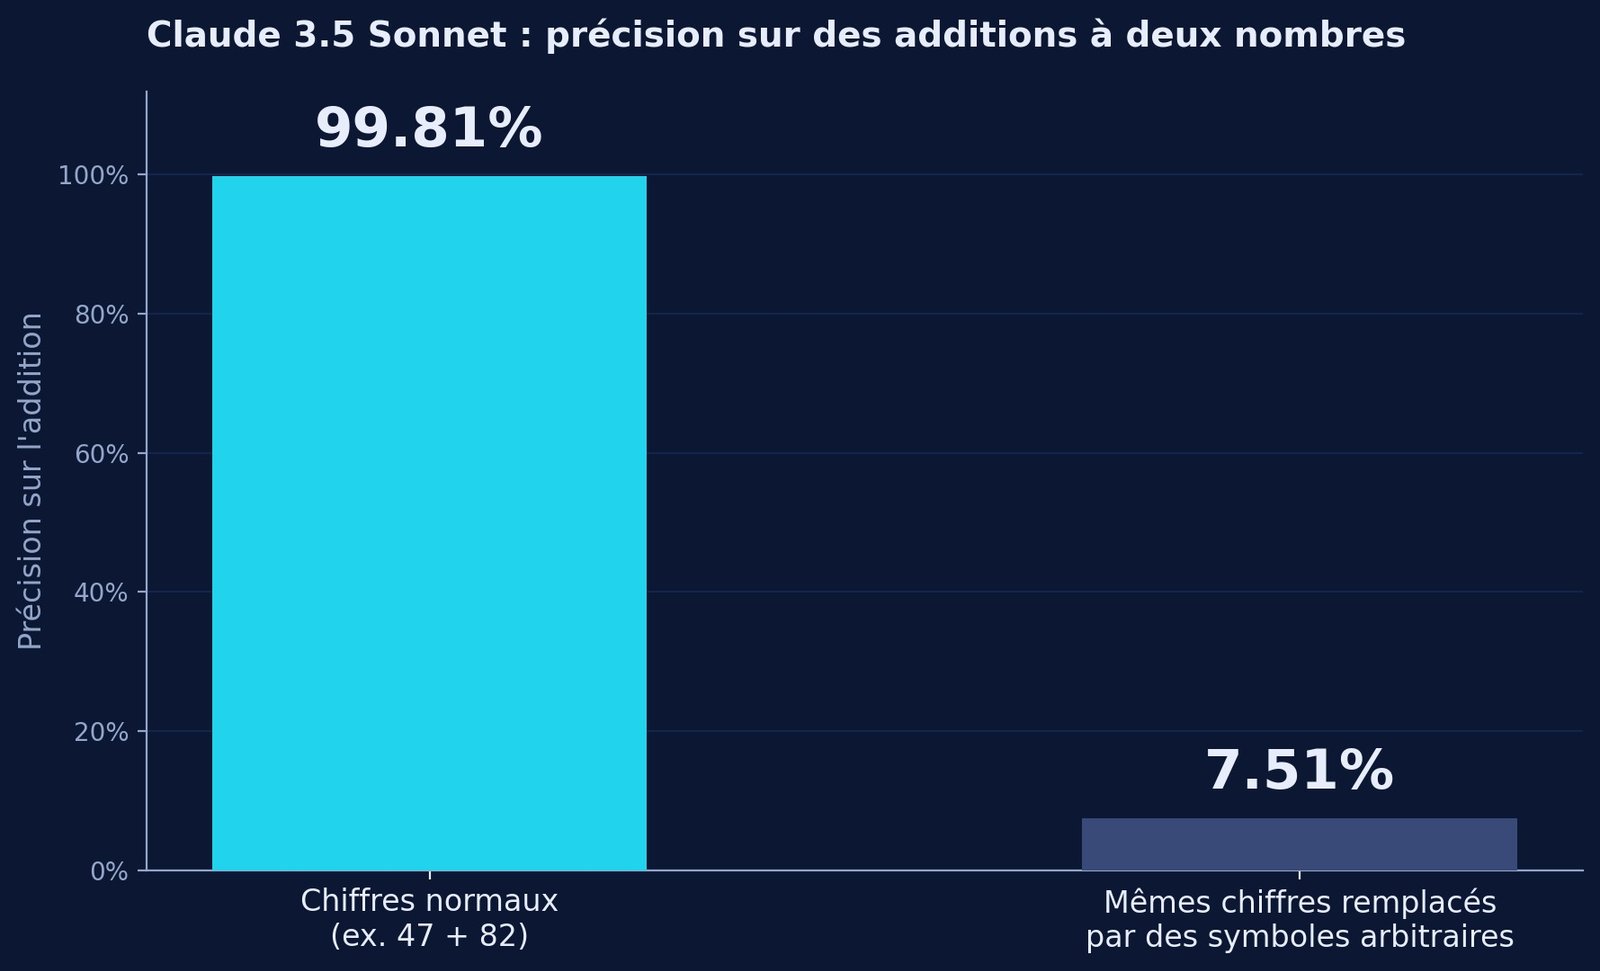
Même valeur, même opération : seule la notation change. La précision s'effondre de 99,81 % à 7,51 %. Source : [4]
Ce résultat, mesuré sur Claude 3.5 Sonnet par une équipe de recherche indépendante, est le plus parlant : le modèle n'a pas perdu sa capacité de calcul, il a perdu ses repères de notation. Il ne fait pas le calcul, il reconnaît un motif visuel appris par cœur.
Pourquoi ça empire avec les grands nombres
Le problème ne grandit pas de façon régulière avec la taille des nombres : la même étude relève une variation non monotone selon le nombre de chiffres, autrement dit des sauts de performance imprévisibles plutôt qu'une dégradation progressive et lisible [4]. Plus troublant encore : les chercheurs ont recensé plus de 1 700 cas où un modèle calcule A + B différemment de B + A, alors que l'addition est par définition commutative. Un humain qui maîtrise l'addition ne fait jamais cette erreur ; un modèle qui l'a seulement mémorisée, si.
Ce que les laboratoires essaient pour corriger le tir
Plusieurs pistes techniques cherchent à contourner le problème plutôt qu'à le résoudre à la source. La tokenisation de droite à gauche avec séparateurs de milliers restaure une partie de la structure positionnelle perdue [3]. Une méthode nommée Abacus Embeddings attache à chaque chiffre sa position réelle dans le nombre : entraînée sur des additions à 20 chiffres, elle atteint 97,9 % de précision sur des additions à 100 chiffres, là où les modèles classiques stagnent entre 20 et 30 % [5].
Aucune de ces méthodes n'est encore le standard des modèles grand public que vous utilisez aujourd'hui. C'est précisément pour cette raison que le problème reste, à ce jour, une réalité quotidienne plutôt qu'une anecdote de recherche.
Ce qu'il faut en retenir
Un modèle de langage ne "voit" jamais un nombre comme une quantité. Il voit une suite de fragments de texte, découpés selon des statistiques d'entraînement, et il a appris à produire la suite de fragments qui suit généralement ce genre de motif. Que la réponse soit juste ou fausse dépend de ce qu'il a mémorisé, pas d'une compréhension de l'arithmétique. Pour une facture, un budget ou toute décision qui repose sur un chiffre exact, la bonne pratique reste la même : faites vérifier le calcul par un outil de calcul réel, pas par la mémoire d'un modèle de langage.
Sources principales :
- arXiv : "A Triadic Suffix Tokenization Scheme for Numerical Reasoning"
Cite le cas "9.11 > 9.9" comme illustration documentée de l'échec de magnitude lié à la tokenisation. (arxiv.org) - Kluster : "Tokenisation : fonctionnement et réglages pour LLM"
Détaille le découpage BPE des nombres selon la fréquence de co-occurrence des caractères plutôt que leur logique numérique. (kluster.fr) - arXiv : "A Triadic Suffix Tokenization Scheme for Numerical Reasoning"
Décrit l'exemple de fragmentation de "100400" et les pistes de tokenisation de droite à gauche. (arxiv.org) - arXiv : "Do Large Language Models Truly Grasp Addition? A Rule-Focused Diagnostic Using Two-Integer Arithmetic"
Mesure la chute de précision de 99,81 % à 7,51 % sous notation symbolique et recense plus de 1 700 violations de commutativité. (arxiv.org) - Essays by John Loeber : "Everything we know about LLMs doing Arithmetic"
Détaille les résultats des Abacus Embeddings : 97,9 % de précision sur des additions à 100 chiffres après entraînement sur 20 chiffres. (essays.johnloeber.com)
Une newsletter par semaine, gratuite.
Actus IA, tutoriels et outils. Zero spam, desabonnement en 1 clic.
Notez cet article